EN
Information Lifecycle Journey
In the contemporary landscape driven by data, the efficient management of information has emerged as a top priority for businesses and organizations, regardless of their scale.
Information Lifecycle Management (ILM) stands as an all-encompassing strategy that guides these entities through the intricate journey of data and information, spanning from its inception to eventual retirement.
The concept of ILM, is based on its actionable insights and on its critical implementation to enhance the value chain of all data assets.

What is Information Lifecycle Management (ILM) ?
Information Lifecycle Management is a structured approach to managing data and information throughout its entire lifecycle, from creation and initial storage to archiving and eventual disposal.

The Stages of Information Lifecycle Management
- Creation and Capture: This is where data and information are born. It can be in the form of documents, emails, databases, or any other digital asset. The goal here is to ensure that data is captured accurately and consistently from the outset.
- Active Use and Maintenance: During this stage, data is actively used for daily operations. It's crucial to maintain data quality, ensure accessibility, and implement security measures to protect sensitive information.
- Archival and Retention: Not all data retains its value indefinitely. Archival and retention policies determine how long data should be kept and where it should be stored once it's no longer in active use. This stage involves transitioning data to cost-effective storage solutions, often in offline or less frequently accessed storage media.
- Deletion and Disposal: When data reaches the end of its useful life or is no longer required due to regulatory or compliance reasons, it must be securely deleted or destroyed to mitigate risks associated with data breaches and privacy violations.
IT
Open & Big Data
Open Data
Gli Open Data, o dati aperti, sono dati accessibili a tutti, messi a disposizione da Pubbliche Amministrazioni o aziende private che possono essere riutilizzati per diversi scopi.
Storia degli Open Data
L’approccio alla cosiddetta governance della cosa pubblica si è affermato a livello internazionale nel 2009.
Nello stesso giorno del suo insediamento e come primo atto, il presidente degli Stati Uniti Barack Obama ha, infatti, pubblicato un memorandum sulla trasparenza e l’Open Government indirizzato ai dirigenti della sua amministrazione.
Il testo si apre con questa affermazione:
Stati Uniti - Barack Obama 2009
La mia amministrazione si impegna a dare vita a un grado di apertura (openness) nel governo senza precedenti. Lavoreremo assieme per assicurare la fiducia pubblica e per stabilire un sistema basato sulla trasparenza, sulla partecipazione pubblica e sulla collaborazione. L’apertura rafforzerà la nostra democrazia e promuoverà l’efficienza e l’efficacia dell’amministrazione.
Al Memorandum hanno fatto seguito, poco più di un anno dopo, la Open Government Directive dell’8 dicembre del 2009, incentrata sui principi di Trasparenza, Partecipazione e Collaborazione, che prescrive compiti, processi e modelli organizzativi che gli enti pubblici sono chiamati a seguire, e la Open Government Initiative che raccoglie le iniziative per l’Open Government dell’amministrazione federale americana in un sito progettato per favorire la partecipazione e i feedback dei visitatori.
Sull’esempio americano molti Paesi si sono avvicinati al tema dell’Open Government, avviando il processo di cambiamento dello scenario pubblico, verso una maggiore trasparenza e vicinanza ai cittadini.
Stati Uniti - Clinton Al Gore 1993
Le Autostrade dell' Informazione
Il 26 ottobre 1993 - New York Times: “Una delle tecnologie che il Vice Presidente Al Gore sta spingendo è l’autostrada dell’informazione, che collegherà tutti a casa o in ufficio a tutto il resto del mondo — (film e spettacoli televisivi, servizi di shopping, posta elettronica e enormi raccolte di dati).”
Al Gore, durante la sua amministrazione intuì l'importanza strategica della connettività digitale e di tutto il suo ecosistema ed architettura digitale, finanziando lo sviluppo della rete e delle tecnologie che hanno dato vita a quello che per primo lui definì “le autostrade dell’informazione”
Al Gore si è battuto negli anni per porre lo sviluppo delle reti telematiche al centro dell’agenda politica degli Stati Uniti.
Organizzazioni Internazionali
Nel 2010 due rapporti internazionali hanno presentato e raccomandato il modello Open Government come chiave per lo sviluppo del settore pubblico e del tessuto produttivo: il rapporto dell’ OCSE “Towards smarter and more transparent government” e il Rapporto UN sullo stato di eGovernment nel mondo ha raccomandato l’adozione di modelli amministrativi aperti.
Unione Europea
In Europa, è la Dichiarazione di Malmo sulle politiche di eGovernment del 2009 a proporre un primo percorso di apertura delle amministrazioni europee in 5 anni.
Big Data
Di “Big Data” si parla da oltre vent’anni, precisamente da quando, nel 2001, la società di ricerca Gartner li ha identificati dandone una definizione: “risorse informative a elevato volume, velocità e varietà che richiedono forme di elaborazione delle informazioni economiche e innovative per potenziare la comprensione, la presa di decisioni e l’automazione dei processi”.
In pratica, mentre prima si parlava solo di database che contenevano informazioni strutturate in tabelle e gestibili da una singola macchina, a un certo punto la velocità nella generazione di nuovi dati e il loro volume sono diventati ingestibili con gli strumenti tradizionali.
Per provare a comprendere di che quantità di dati si stia parlando, possiamo partire dai metodi di misura che ben conosciamo, ovvero gigabyte (GB) e terabyte (TB).
Con i primi abbiamo familiarità con i nostri smartphone, che ormai mediamente si attestano su memorie da 64 o 128 GB, anche se non è raro trovare modelli di fascia alta che arrivano anche a 256 o 512 GB; con i secondi entriamo solitamente nel campo dei dischi fissi che usiamo come supporto per i nostri computer, magari per memorizzare foto e video, che richiedono molto spazio.
Qui a livello di uso personale parliamo spesso di quantitativi che vanno da 1 a 4 TB, dove un TB equivale a mille GB.
Le 5V dei Big Data
Prima di capire come si possano effettuare analisi su queste informazioni e cosa serva per tradurre in pratica il loro valore è bene fare un passo indietro e capire in base a quali caratteristiche possono essere identificati.
Il modello delle “V” nasce nel lontano 2001, quando l’analista Doug Laney lo descrisse in un report individuando i primi 3 elementi:
Volume, Velocità e Varietà.
Il primo rappresenta la quantità dei dati, il secondo la rapidità con cui vengono generati e il terzo le differenti tipologie.
Nel tempo sono state poi aggiunte due ulteriori “V”: la Veridicità, che si riferisce alla qualità del dato, e la Variabilità, intesa come il diverso significato che può essere attribuito al dato in funzione del contesto in cui lo si colloca.
Ultimamente si tende a considerare anche il Valore del dato, ovvero delle informazioni che possono essere ottenute mediante l’elaborazione e l’analisi di grandi set di dati.
4 categorie di Analytics:
Descrittiva, che si limita a offrire una visione attuale e passata delle informazioni;
Predittiva, in cui strumenti avanzati provano a indicare tendenze future;
Prescrittiva, che arriva a proporre ai responsabili decisionali soluzioni strategiche sulla base dell’analisi effettuata;
Automatizzata, con strumenti capaci di portare avanti in modo autonomo le azioni necessario identificate durante il processo di analisi.
A queste si potrebbe aggiungere la categoria diagnostica, che serve a identificare le cause che hanno portato a uno specifico evento.
5 tendenze principali
La prima è quella legata all’automatizzazione degli strumenti di intelligenza artificiale (AI) e di machine learning (ML).
L’obiettivo è quello di semplificare, uniformare e automatizzare le attività di data entry.
La seconda è quella di trovare soluzioni che portino al marketing geo-localizzato e a informazioni di dettaglio.
Una terza tendenza è più legata all’adozione di soluzioni di cloud ibrido, con processi eseguiti parzialmente all’interno del data center aziendale e in parte su infrastrutture pubbliche, e di “edge computing”, ovvero di strumenti di gestione dei dati collocati anche in sedi distaccate o periferiche.
La necessità di gestire e analizzare dati che provengono da siti remoti rispetto all’azienda e di inserirli in un contesto dove il cloud ibrido è sempre più diffuso spiega l’esigenza di un’infrastruttura capace di adeguarsi a questi nuovi scenari.
Il quarto trend si sposta più sul fronte pubblico, dove la sempre maggiore diffusione di Open-data e la necessità di informazione in tempo reale portano alla ricerca di strumenti capaci di seguire in tempo reale lo stato di avanzamento dei grandi lavori e lo sviluppo di progetti strategici per l’Italia.
Infine, la quinta tendenza è quella verso la catalogazione dei dati, che sfrutta il modello integration-Platform-as-a-Service (iPaaS), per integrare applicazioni che vengono eseguite on-premises e nel cloud.
L'organizzazione del III millennio deve diventare “Data-driven” ed avere specialisti del settore come:
Data Analyst – esplora, analizza e interpreta i dati, con l’obiettivo di estrapolare informazioni utili al processo decisionale
Data Scientist – è la figura professionale che si occupa delle fasi di sviluppo, training e testing di modelli statistici e algoritmi di apprendimento automatico
Data Engineer – gestisce le fasi di raccolta, processamento e integrazione dei dati.
Data Science Programme Manager – gestisce l’intero processo di Data Science, coordinando un team centrale o favorendo la crescita e la formazione di analoghe figure distribuite.
Altra figura non meno importante è quello dello specialista che conosce perfettamente il nuovo linguaggio del "Prompt Engineering" che risulta essere di estrema importanza per utilizzare al meglio la potenza di calcolo dei supercomputer.
Links:
>>> Euro Stats
>>> EU Open Data
EU Open Data Apps
>>> https://data.europa.eu/en/apps
>>> Open Data Handbook
>>> Open Knowledge
>>> Open Data Impact Map
>>> Amelia Data Fabric
Toolbox
Top Tools
Microsoft Power BI

Tableau

Strategy

Zoho Analytics

Discover Caspio
Discover Statista
Discover Knime
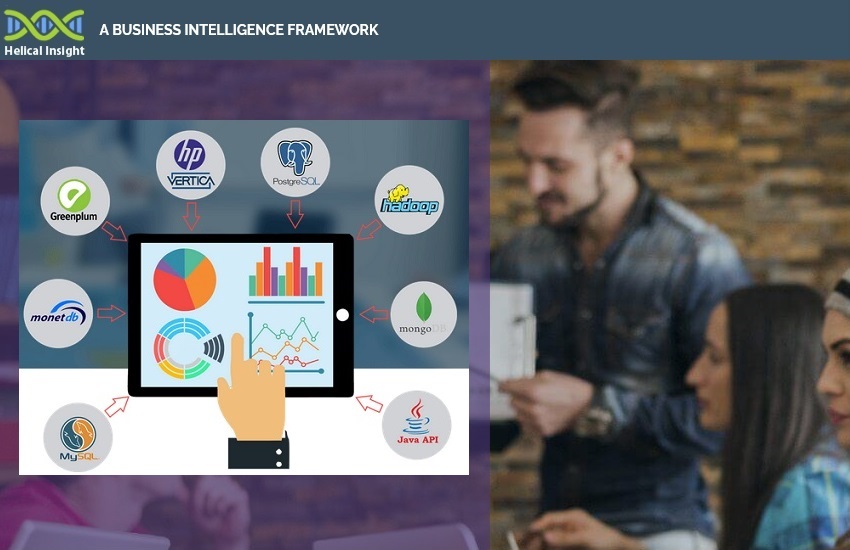
Discover Helical Insight
Discover Zapier
ClickUp
Seeed Studio
>>> https://superset.apache.org
>>> https://lookerstudio.google.com
... and many others ...